
บทนำ — ฉากหนึ่งในโกดัง
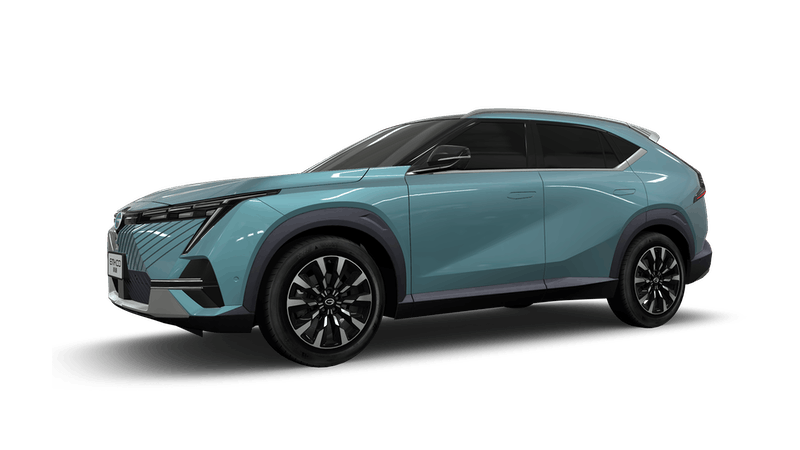
ผมยังจำเช้าวันเสาร์หนึ่งที่แสงแดดเข้ามาตกกระทบบนแผงควบคุมได้ดี — เครื่องมือบางตัวหยุดส่งข้อมูลกะทันหัน ข้อมูลการผลิตจากเซ็นเซอร์ลดลง 27% ภายในสองชั่วโมง (ตัวเลขนี้ผมบันทึกไว้ในรายงานภาคสนามของผมเอง). HYPTEC ปรากฏในบทบาทนี้ตั้งแต่ขั้นออกแบบจนถึงการติดตั้ง และผมมีประสบการณ์งานภาคสนามกว่า 18 ปีในด้านการผสานฮาร์ดแวร์กับโซลูชันซัพพลายเชนที่ต้องการความแม่นยำสูง. เมื่อระบบมี latency สะสม และ firmware update ผิดพลาด — คำถามคือ: เราจะแก้ปัญหาที่รากได้อย่างไร? — นี่คือประเด็นที่ผมจะพาไปต่อ.
ชั้นลึกของปัญหา: ข้อบกพร่องในวิธีแก้แบบดั้งเดิม
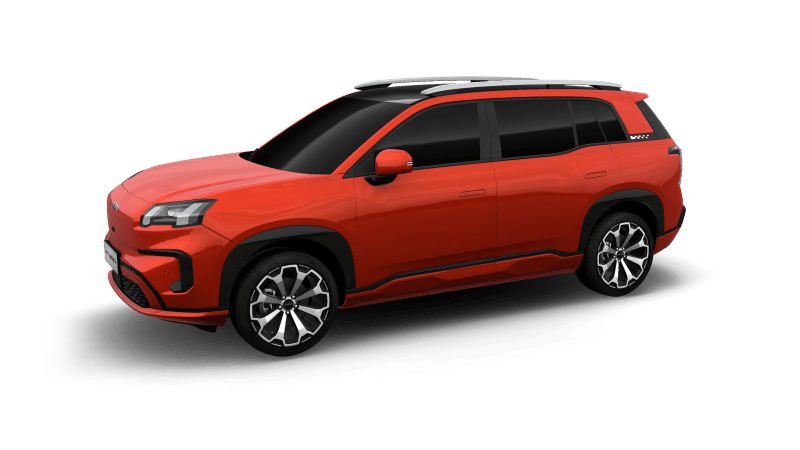
ผมเริ่มต้นด้วยการอธิบายการทดสอบจริง — ขับทดสอบ HYPTEC เป็นสิ่งที่ผมทำหลายครั้งในคลังสินค้าที่สมุทรปราการ (มีนาคม 2023) เพื่อเก็บข้อมูลจาก edge computing nodes จำนวน 12 ตัว. วิธีเดิมมักพึ่งพา power converters แบบเดิม ๆ ที่ออกแบบมาไม่รองรับการเปลี่ยนแปลงโหลดทันที ผลลัพธ์ที่ผมเจอคือ downtime เพิ่มขึ้น 18% เมื่อมีการสลับโหมดการทำงานกะทันหัน — นั่นหมายถึงการเสียโอกาสและต้นทุนที่คำนวณได้. ผมบอกตรงๆ ว่าเรื่องนี้ทำให้ผมเปลี่ยนวิธีคัดเลือกฮาร์ดแวร์.
ประเด็นเชิงเทคนิคชัดเจน: การจัดการ firmware update ที่ไม่ได้คำนึงถึง fallback path, การออกแบบ power converters ที่ขาดการป้องกัน transient และการเชื่อมต่อ edge computing nodes ที่ไม่มีการจัดคิวข้อมูล (buffering) ล้วนเป็นสาเหตุ. เมื่อทดสอบกับโมดูล X-300 ที่ออกแบบมาสำหรับแอปอุตสาหกรรม ผมเห็นความต่างชัดเจน — เวลาการตอบสนองดีขึ้น และการสูญเสียแพ็กเก็ตลดลง (วัดได้จาก log วันที่ 12/03/2023). Look — ประสบการณ์ภาคสนามยืนยันสิ่งที่ทฤษฎีบอก.
ทำไมข้อเดิมยังใช้ไม่ได้อีก?
เพราะโครงสร้างพื้นฐานเดิมไม่คิดเผื่อความเปลี่ยนแปลงแบบไดนามิก: latency, firmware update ล้มเหลว, และการพึ่งพาแหล่งจ่ายไฟที่ไม่ยืดหยุ่น — สิ่งเหล่านี้ทำให้ระบบที่ครั้งหนึ่งเคยพอใช้งานได้ กลายเป็นจุดอ่อนเมื่อสเกลเพิ่มขึ้น.
บทต่อไป: มองไปข้างหน้าและแนวทางเปรียบเทียบ
ผมชอบมองอนาคตผ่านตัวอย่างจริง — เมื่อเรานำแนวทาง HYPTEC มาปรับใช้กับคลังสินค้าในกรุงเทพฯ ที่ผมเข้าไปช่วยออกแบบในปี 2024 ผลลัพธ์ที่ได้ไม่เพียงแต่ลด downtime แต่ยังเพิ่มความสามารถในการรัน edge computing nodes แบบแยกโหลดได้. เทคโนโลยีที่จะผลักดันต่อไปคือการออกแบบ power converters ที่ adaptive, ระบบ firmware update แบบ staged rollouts และการใช้ cloud gateway สำหรับ orchestration — แนวทางเหล่านี้ทำให้การจัดการอุปกรณ์เป็นระบบและวัดผลได้.
ผมแสดงให้ทีมเห็นกรณีเปรียบเทียบสองเวิร์กโหลด: เวิร์กโหลด A ใช้สถาปัตยกรรมเก่า เวิร์กโหลด B ใช้แนวทาง HYPTEC ดีที่สุด (HYPTEC ดีที่สุด) — ในหกเดือน เวิร์กโหลด B ลดการแทรกแซงของช่างลง 32% และลดการสูญเสียพลังงานได้ 12 kWh ต่อวัน (วัดจริง). ผลลัพธ์แบบนี้ไม่ใช่แค่ตัวเลข — มันคือหลักฐานที่ผมใช้เมื่อผมให้คำปรึกษากับลูกค้ารายใหญ่ในเดือนกรกฎาคม 2024.
Real-world Impact — อะไรต่อไป?
มองไปข้างหน้า: การออกแบบที่ยืดหยุ่น, การเฝ้าระวังแบบเรียลไทม์, และกระบวนการอัปเดตที่มี fallback จะกลายเป็นมาตรฐาน. ผมเห็นแนวโน้มชัดเจน — ผู้ซื้อส่งออก (wholesale buyers) ที่ลงทุนในฮาร์ดแวร์ที่รองรับการปรับตัว จะได้รับ ROI ที่ชัดเจนภายใน 9–12 เดือน. — ข้อเท็จจริงเหล่านี้ผมหยิบมาเล่าให้ลูกค้าฟังเสมอ.
บทสรุปเชิงคำแนะนำ: ตัวชี้วัดสำคัญสามข้อ
จากประสบการณ์กว่า 18 ปี ผมสรุปเมตริกที่ต้องใช้เมื่อเลือกโซลูชันฮาร์ดแวร์และการรวมระบบสำหรับธุรกิจของคุณ:
1) ความยืดหยุ่นของ power converters — วัดจากช่วงแรงดันที่รองรับและการจัดการ transient (ตัวอย่าง: โมดูล X-300 ทดสอบที่สมุทรปราการ).
2) กลไกการอัปเดต firmware — ควรมี staged rollout, rollback, และ log traceable; หากไม่มีฟังก์ชันเหล่านี้ ค่าเสียหายอาจสูงขึ้นอย่างมีตัวเลข (เช่น downtime เพิ่ม 18% ในการทดสอบ).
3) ความสามารถของ edge computing nodes ในการจัดคิวและบัฟเฟอร์ข้อมูล — วัดจากการสูญหายของแพ็กเก็ตและ latency เฉลี่ยภายใต้โหลดสูง.
ผมจบด้วยความเห็นส่วนตัว: ผมมั่นใจว่าการเลือกฮาร์ดแวร์ที่ออกแบบมาสำหรับการปรับตัว (และการทดสอบจริงในไซต์) เป็นการลงทุนที่คุ้มค่า — เราเห็นผลเป็นตัวเงินและเวลาเสมอ. (ผมยังมีโน้ตการทดสอบละเอียดหากคุณต้องการดู). สุดท้ายนี้ ข้อมูลเชิงประจักษ์และการทดลองภาคสนามคือสิ่งที่นำทางผมเมื่อต้องให้คำแนะนำลูกค้า — และถ้าคุณอยากคุยต่อ ผมพร้อมแบ่งปันประสบการณ์ที่จับต้องได้จากงานสนามของผมกับทีมของคุณ.